
开放 API 文档
| 项目 | 说明 |
|---|---|
| 适用场景 | 资源管理、文件上传、网页收藏、搜索、标签和 AI 对话集成 |
| 当前限制 | 基础版空间每 24 小时最多调用 10 次;高级版空间最多调用 1,000 次 |
小黑 OmniBox Open API 是一组使用 Bearer Token 鉴权的 REST API,适用于插件、自动化、系统集成和 Agent 工作流。API Key 可以限制可访问的资源范围和操作权限。
根据部署方式使用对应的 API 地址和 Swagger 文档:
| 地址 | Swagger 文档 | |
|---|---|---|
| 云服务 | api.omnibox.pro | OmniBox Open API Docs |
| 本地部署 | <your-server>/open/api/ | <your-server>/open/api/docs |
获取 API Key
参见:如何创建 API Key
创建 API Key 时可以添加备注,建议记录用途、调用方或关联助手,方便后续管理和清理。
网页端和 App 均可从 设置 > API 密钥 管理密钥。App 支持创建、查看、复制、编辑、删除及权限配置,详细步骤见 如何创建 API Key。
API Key 权限与范围
创建 API Key 时,需要设置 权限范围 和具体权限。
权限范围 决定这个 API Key 可以访问知识库中的哪一部分。新建 API Key 默认选择「个人」,已有密钥不会自动扩大权限范围。也可以选择某个文件或文件夹,仅授权该资源及其子内容。
拥有或加入团队时,可以主动选择「个人 + 团队」。同一把密钥即可访问当前空间内自己的「个人」资源及「团队」中有权限的资源,不包含其他成员的「个人」资源。选项与知识库中的团队入口保持一致:仅剩自己且团队内没有内容时,不显示团队相关选项。
权限范围与保存位置分别处理:新建内容、收藏链接和上传文件时,显式指定的保存目录优先;没有指定时,保留助手已有的明确保存位置,否则默认保存到「个人」。指定位置不可用或没有权限时直接报错,不会自动改存「个人」。修改、删除已有资源仍作用于原资源,不转存或创建副本。
在 API 密钥列表中,系统会展示具体的资源权限范围;点击资源名称可以进入对应资源详情,方便确认 API Key 的可访问范围。
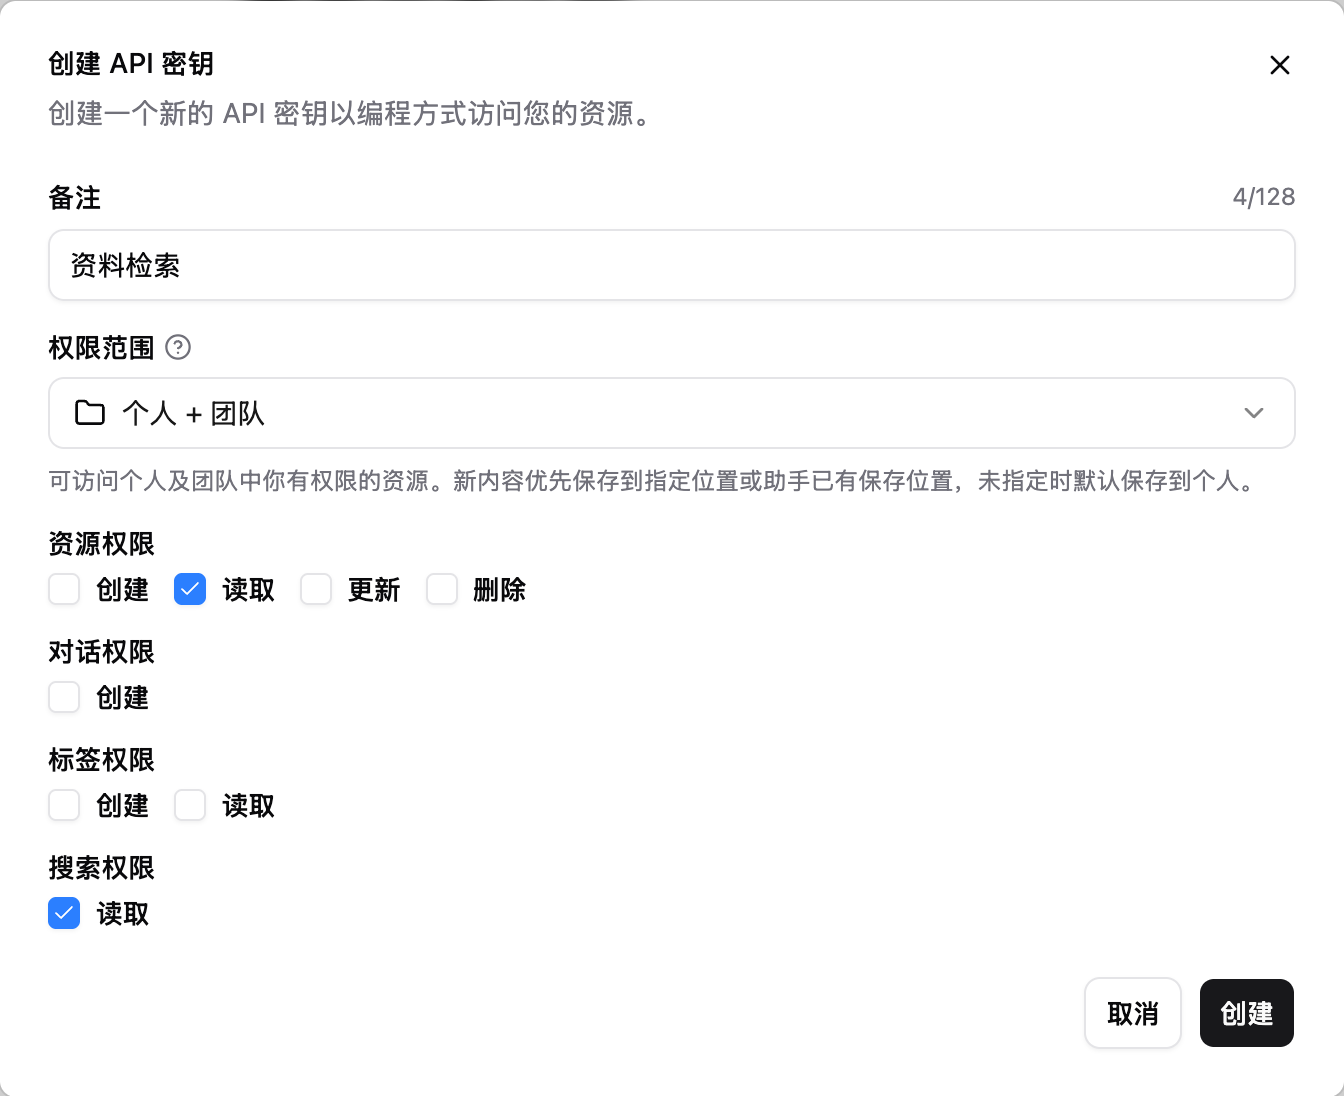
目前支持的权限包括:
| 权限 | 可选操作 | 说明 |
|---|---|---|
资源权限 | 创建、读取、更新、删除 | 管理文件、文件夹、资源内容、资源标签关联、网页收藏和文件上传 |
对话权限 | 创建 | 调用 AI 对话能力 |
标签权限 | 创建、读取 | 创建标签、查询标签 |
搜索权限 | 读取 | 在 API Key 的权限范围内搜索资源 |
如果 API Key 没有所需权限,接口会返回权限不足。建议只勾选当前集成真正需要的权限,避免给自动化脚本过大的访问范围。
在外部 Agent 中使用 Open API Skill
如果你希望让外部 Agent、自动化脚本或内部工具调用小黑 Open API,建议先让 Agent 读取小黑提供的 SKILL.md。该文件会说明 Open API 地址、认证方式、权限范围、额度规则和常用调用流程。
加载 Open API Skill 后,Agent 可以识别小黑资源链接、空间链接和分享链接,并根据链接上下文调用对应的 Open API 能力。
云服务地址:
https://api.omnibox.pro/v1/SKILL.md自部署场景请使用你的 Open API 访问地址,例如:
https://<your-domain>/open/api/v1/SKILL.md调用次数限制:
- 基础版空间:每 24 小时 10 次
- 高级版空间:每 24 小时 1000 次
调用 Open API 时请使用 Bearer Token:
Authorization: Bearer <api-key>安全建议:不要把 API Key 写入日志、文档、URL 或聊天上下文。完整接口参数和响应结构请以 Swagger 文档 以及 SKILL.md 为准。
读取文档评论
使用具有「资源读取」权限(resources:read)的 API Key,可以读取全文评论、行内评论和已有回复。文档必须在密钥的授权范围内,密钥所属用户仍是空间成员且有查看权限。本接口只提供读取。
以下路径相对于 Open API v1 基址:云服务为 https://api.omnibox.pro/v1,自部署为 <your-server>/open/api/v1。
GET /resources/<resource_id>/comment-threads?type=all&offset=0&limit=20
Authorization: Bearer <api-key>

GET /resources/<resource_id>/comment-threads/<thread_id>/comments?offset=1&limit=20
Authorization: Bearer <api-key>| 参数 | 默认值 | 说明 |
|---|---|---|
type | all | 仅线程列表:all(全部)、document(全文)或 inline(行内) |
resolved | 不筛选 | 仅线程列表:字符串 true 或 false |
offset | 0 | 非负十进制整数 |
limit | 20 | 1–100 的十进制整数 |
两个接口都返回 items、total、offset、limit、has_more。线程列表的 total 统计线程,每个线程只预览 1 条仍存在的评论。检查 comments_pagination:若 has_more=true,通过第二个接口从 offset=1 继续读取;也可直接从 offset=0 独立读取完整线程。第二个接口的 total 统计评论,并返回当前页的 mention_display_names。两层分页都需要遍历到 has_more=false。
线程与评论均按创建时间、ID 升序排列。最初的评论被删除后,第一条可能是回复。不同请求之间有增删时,offset 可能移动,完整遍历以数据稳定为前提。有权访问但无评论的文档返回空列表;offset 超出末尾时仍返回实际总数。已删除数据不返回。
全文评论的 anchor=null;行内锚点使用编辑器位置,失效锚点(orphaned)仍保留。默认包含已解决线程。作者和创建者仅包含可为空的 id、display_name,有成员名称快照时保留。正文保留 mention 短码。纯图片评论的文本可以为空,附件仅返回 id、name、mimetype、size。本期不提供评论附件下载、评论写入或解决状态修改。
两个接口及后续每页请求均消耗现有 Open API 额度,部分失败请求也可能消耗额度。错误码:400 参数错误、401 密钥无效、403 超出授权范围或没有权限、404 文档/线程不存在或线程属于其他文档、429 额度耗尽。分页不接受空值、数组/重复参数、小数、负数或科学计数法。
下面的 Python 示例遍历两层分页。将 OMNIBOX_API_BASE 设为包含 /v1 的基址,OMNIBOX_API_KEY 设为密钥,OMNIBOX_RESOURCE_ID 设为文档 ID。示例从环境变量读取密钥,不打印密钥。
import json
import os
from urllib.parse import quote, urlencode
from urllib.request import Request, urlopen

base = os.environ['OMNIBOX_API_BASE'].rstrip('/')
key = os.environ['OMNIBOX_API_KEY']
resource_id = quote(os.environ['OMNIBOX_RESOURCE_ID'], safe='')

def get_json(path, params):
    request = Request(
        f'{base}{path}?{urlencode(params)}',
        headers={'Authorization': f'Bearer {key}'},
    )
    with urlopen(request, timeout=30) as response:
        return json.load(response)

thread_path = f'/resources/{resource_id}/comment-threads'
thread_offset = 0
while True:
    page = get_json(thread_path, {'type': 'all', 'offset': thread_offset, 'limit': 20})
    for thread in page['items']:
        comments = list(thread['comments'])
        metadata = thread['comments_pagination']
        comment_offset = metadata['offset'] + len(comments)
        while metadata['has_more']:
            path = f"{thread_path}/{quote(thread['id'], safe='')}/comments"
            reply_page = get_json(path, {'offset': comment_offset, 'limit': 100})
            if not reply_page['items'] and reply_page['has_more']:
                raise RuntimeError('Pagination made no progress')
            comments.extend(reply_page['items'])
            comment_offset = reply_page['offset'] + len(reply_page['items'])
            metadata = reply_page
        print(json.dumps({'thread_id': thread['id'], 'comments': comments}, ensure_ascii=False))
    if not page['has_more']:
        break
    if not page['items']:
        raise RuntimeError('Pagination made no progress')
    thread_offset = page['offset'] + len(page['items'])